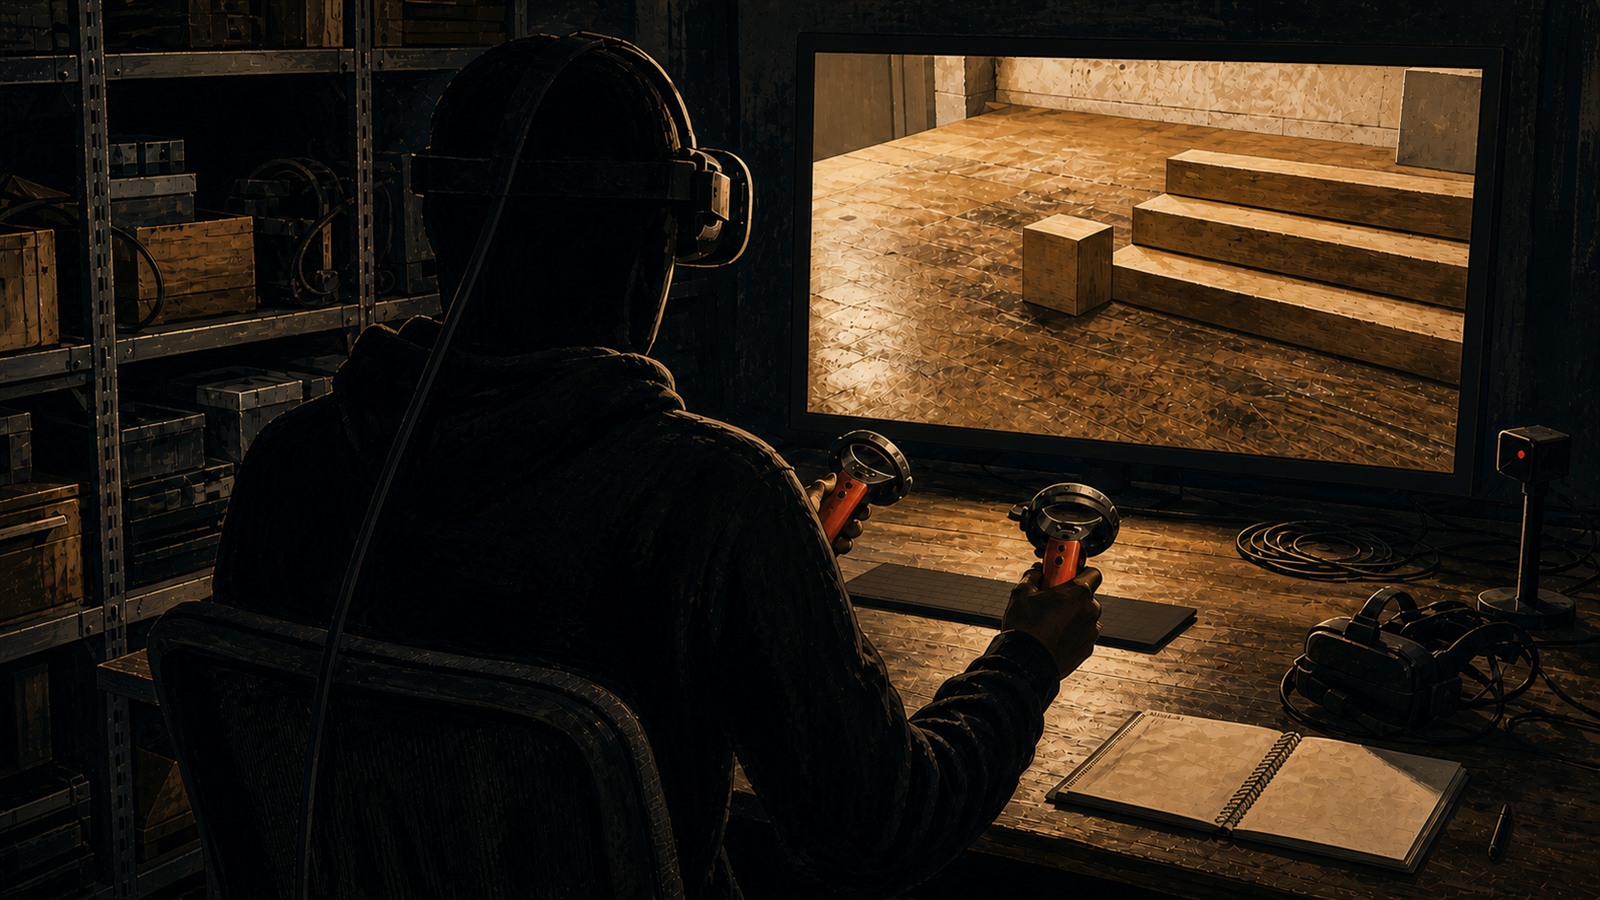
로봇 영상은 결과를 먼저 보여 준다. 계단을 오르고, 물건을 옮기고, 균형을 잡는 장면이 화면을 채운다. 그 장면이 매끄러울수록 우리는 뒤의 통제 구조를 덜 묻는다. 마치 로봇이 스스로 판단한 것처럼 받아들이게 된다.
영상은 조종석을 잘라낸다
「Towards Miniature Humanoid Tele-Loco-Manipulation Using Virtual Reality and Reinforcement Learning」은 제목과 초록에서 소형 휴머노이드의 이동·조작을 가상현실 원격 조작과 강화학습 제어의 결합으로 다룬다고 밝힌다.1 자율 로봇이 혼자 과제를 끝냈다는 연구가 아니라, 전문 조작자와 제어 시스템이 함께 구성한 원격 조작 실험이라는 범위를 지켜 읽어야 한다.
행위자성을 부여하는 습관
사람은 목적을 가진 듯 움직이는 대상에 쉽게 행위자성을 부여한다. 인간-로봇 상호작용 연구는 로봇의 형태와 움직임, 행동 단서가 사람으로 하여금 인간적인 정신 능력을 귀속하게 만드는 과정을 다차원적으로 설명한다.2 화면만 보고 “스스로 판단했다”고 말하기 전에 조종자, 학습된 제어, 촬영 조건을 따로 확인해야 한다.
결과만 같으면 충분하다는 말의 한계
물건을 옮기는 데 성공했다면 누가 조종했는지는 중요하지 않다는 반론도 가능하다. 실용적인 현장에서는 어느 정도 맞는 말이다. 하지만 공유 자율성 연구가 설명하듯 원격 조작과 완전 자율 사이에는 사람이 목표를 정하고 알고리즘이 일부 동작을 돕는 넓은 중간 지대가 있다.3 결과가 같아도 통제 구조가 다르면 기술의 능력에 관한 주장도 달라진다.
동작 뒤에 감춰진 통제
로봇 영상을 볼 때 남겨 둘 질문은 많지 않다. 이 동작은 반복 가능한가. 조종자나 보조 시스템의 존재가 공개되어 있는가. 제한된 환경이 아닌 다른 조건에서도 가능한가. 로봇의 움직임 의도를 사람에게 어떻게 전달할지를 검토한 HRI 연구도, 움직임만으로 의도와 통제 구조가 저절로 투명해지는 것은 아님을 보여 준다.4 화면 밖을 묻는 습관이 필요한 이유다.
각주
-
Towards Miniature Humanoid Tele-Loco-Manipulation Using Virtual Reality and Reinforcement Learning — arxiv.org, 2026-07-22 발행; 2026-07-25 접속 확인. ↩
-
Anthropomorphism in human–robot interactions: a multidimensional conceptualization — Communication Theory 33(1), 2023. 특정 영상의 시청자 반응이 아니라 로봇에 인간적 속성을 부여하는 해석 틀을 제공한다. ↩
-
Shared Autonomy in Unprepared Environments — Toyota Technological Institute at Chicago. 원격 조작과 완전 자율 사이의 공유 자율성 연구를 설명한다. ↩
-
How to Communicate Robot Motion Intent: A Scoping Review — CHI 2023. 로봇이 실제 의도를 가진다는 주장이 아니라, 사람이 움직임의 목적을 이해하도록 설계하는 연구를 검토한다. ↩
